Da Verständnis einer Problemstellung den ersten Schritt zu ihrer Lösung darstellt, beginnt das Buch von Martin Kleppmann und Chris Riccomini mit umfangreichen Überlegungen zu den an die Datenhaltungsschicht einer Applikation stellbaren Ansprüchen. Schon hier fallen umfangreiche Verweise auf Webquellen positiv auf – sowohl Twitter als auch das BlueSky-Entwicklerteam haben in der Vergangenheit Dokumente veröffentlicht, die dem Datenbankentwickler wertvolle Konzepte kommunizieren. Gedanken zur Entscheidung zwischen Selbst- und Fremdhosting dürfen an dieser Stelle natürlich nicht fehlen.
Mit oder ohne SQL?
Obwohl das Thema NoSQL seine Buzzword-Wirkung mittlerweile zugunsten anderer durch das Dorf getriebener Sauen verloren hat, sind die davon betroffenen Technologien auch heute von größter Relevanz. Nach einer grundlegenden Besprechung der verschiedenen Methoden der Datenhaltung – die Autoren erklären sowohl mit Codesnippets als auch mit Grafiken – folgt eine Besprechung häufig verwendeter Datenstrukturen. Diese helfen sowohl Codierern als auch Architekten dabei, hinter die Kulissen der Datenbank-Engine zu blicken.
Nach der Strukturierung der Daten folgt die Auswahl des zu verwendenden Serialisierungsformats. Die Vorstellung der Vor- und Nachteile von XML, Protocol Buffer und Co. geht auch auf Apache AVRO ein – wie in den vorhergehenden Abschnitten schafft das Buch eine Vermittlung, die sowohl für Codierer als auch für Architekten verständlich ist und sowohl bei eigenen Experimenten mit Datenbankentwicklung als auch beim Design einer datengetriebenen Applikation hilfreich ist.
Daten im Wandel durch Raum und Zeit
Spätestens mit dem Aufkommen des Internets galt, dass sowohl Redundanz als auch Verteilung von Informationen an Relevanz gewannen. Im Laufe der vergangenen Dekaden sammelte die Entwicklerschaft verschiedenste Patterns und Erfahrungen, die das Buch in einer Kapitelgruppe vorstellt. Besonders wertvoll ist hier die Besprechung der Vor- und Nachteile der individuellen Vorgehensweisen, die dem Leser das Verständnis der in den diversen Datenbank-Engines hinterlegten Konfigurationseinstellungen ermöglicht beziehungsweise erleichtert.
Ab einer gewissen Komplexität gilt, dass der Datenbestand räumlich verteilt werden muss: Sowohl in einem Rechenzentrum als auch in einem Land treten dabei Probleme auf. Das Buch stellt diese gekonnt vor; neben dem Problem der Konsensusfindung gibt es detaillierte Ausführungen zur oft überschätzten Problematik der Vorhaltung eines netzwerkweit gültigen Zeitstempels.
Von Batch und Strom
Googles MapReduce-Algorithmus hat die Welt der Batch-Verarbeitung verändert, um danach wieder in der Versenkung zu verschwinden. Das Buch beginnt seine Überlegungen mit der Besprechung einer aus Kommandozeilenwerkzeugen zusammengestellten Pipeline, um danach verschiedene reale Implementierungen vorzustellen.
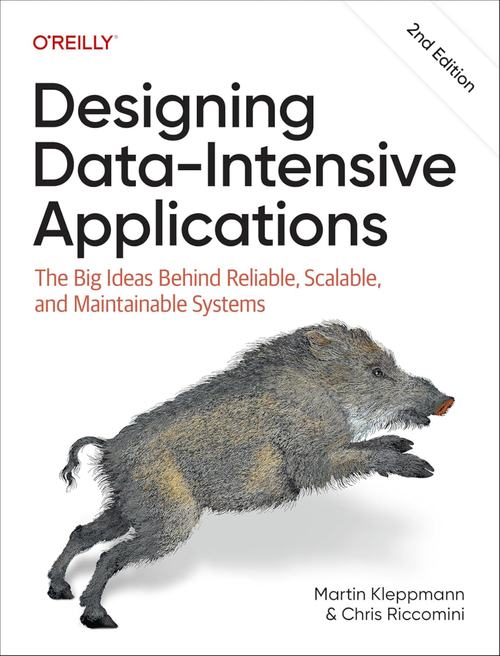
Autoren: Martin Kleppmann, Chris Riccomini
Titel: Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems
Seiten: 821
Verlag: O'Reilly Media, 2026, 2. Aufl.
ISBN: 978-1098119065
Sprache: Englisch
Gegenteil der Batch-Verarbeitung ist die Strom-Verarbeitung. Neben den verschiedenen Quellen der per Stream verarbeitbaren Daten stellt das Buch Systeme zur Verteilung von Datenströmen vor und geht auch auf praktische Probleme ein. Zu guter Letzt findet sich im dreizehnten Kapitel eine durchbesprochene Referenzimplementierung eines Gesamtsystems, die die besprochenen Gedanken und Verfahren zusammenfasst und illustriert.
Fazit
Mit der zweiten Auflage von „Designing Data-Intensive Applications“ gelingt O’Reilly eine im Allgemeinen gelungene Aktualisierung eines schon vor zehn Jahren lesenswerten Buchs. Wer eine detaillierte Einführung in grundlegende und fortgeschrittene Datenverarbeitung begehrt, bereut den Kauf auf keinen Fall. Das vierzehnte Kapitel soll der nicht an Maschinensturm interessierte Leser einfach links liegen lassen, um seinen Blutdruck zu schonen.